Redline CoachConception système, ingénierie IA et design produit
Vue d’ensemble
Redline lit mes sorties Strava, planifie mes semaines d’entraînement et envoie tout sur Messenger. J’ai construit tout ce qui entoure le modèle : ce qu’il lit, ce qu’il a le droit de modifier, et comment je vérifie qu’il a raison.
Quotidienusage réel depuis juillet 2026
1,500+tests automatisés
40scénarios d’évaluation
113sources dans sa base de connaissances
Dans le projet
L’IA là où elle aide, le code là où il faut avoir raison
L’interface était déjà dans ma poche
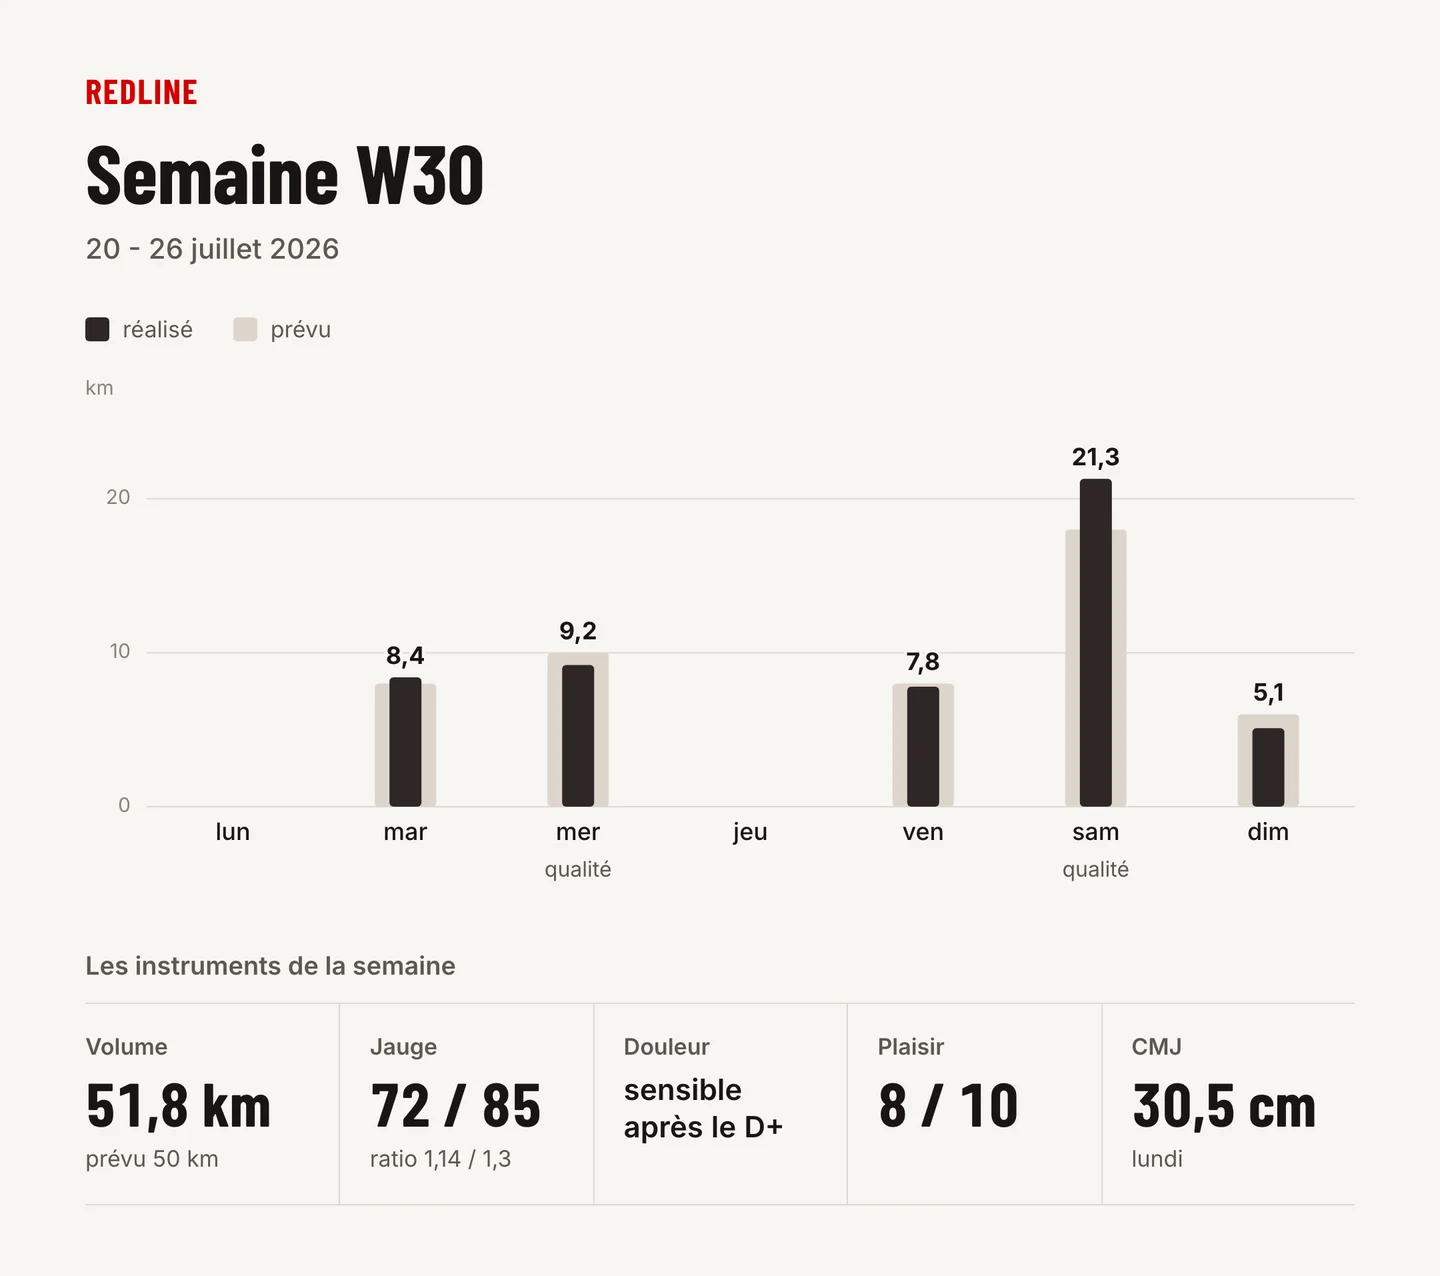
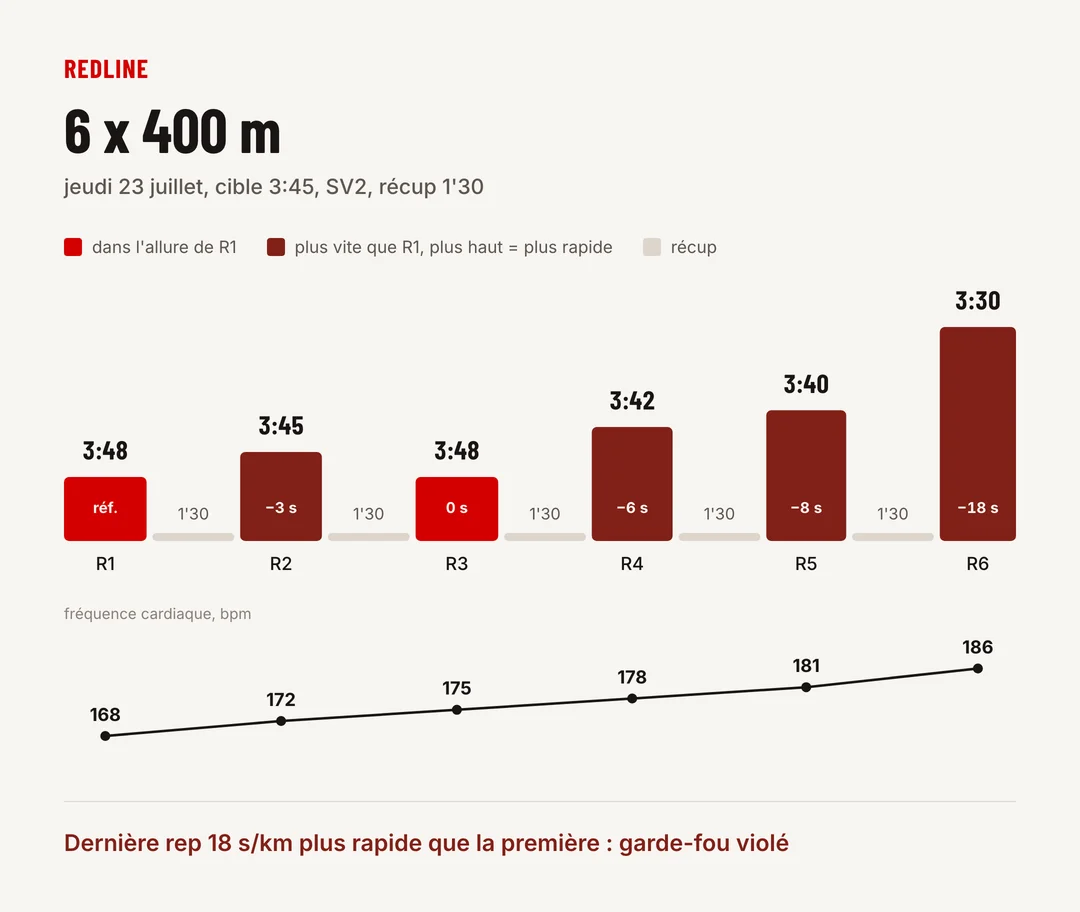
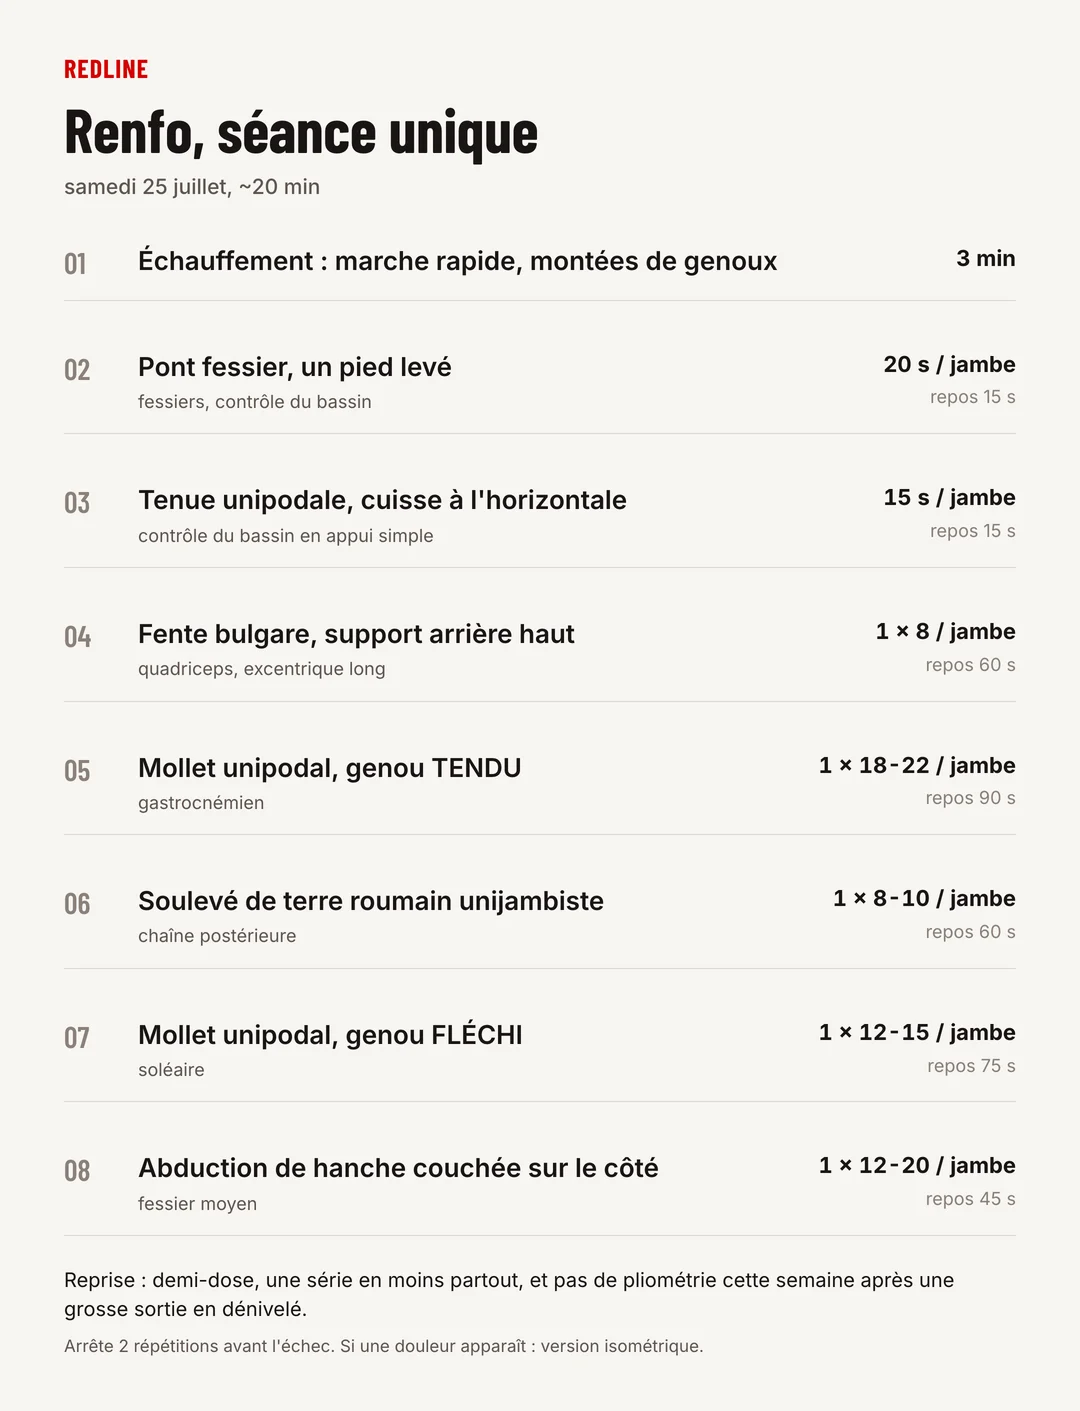
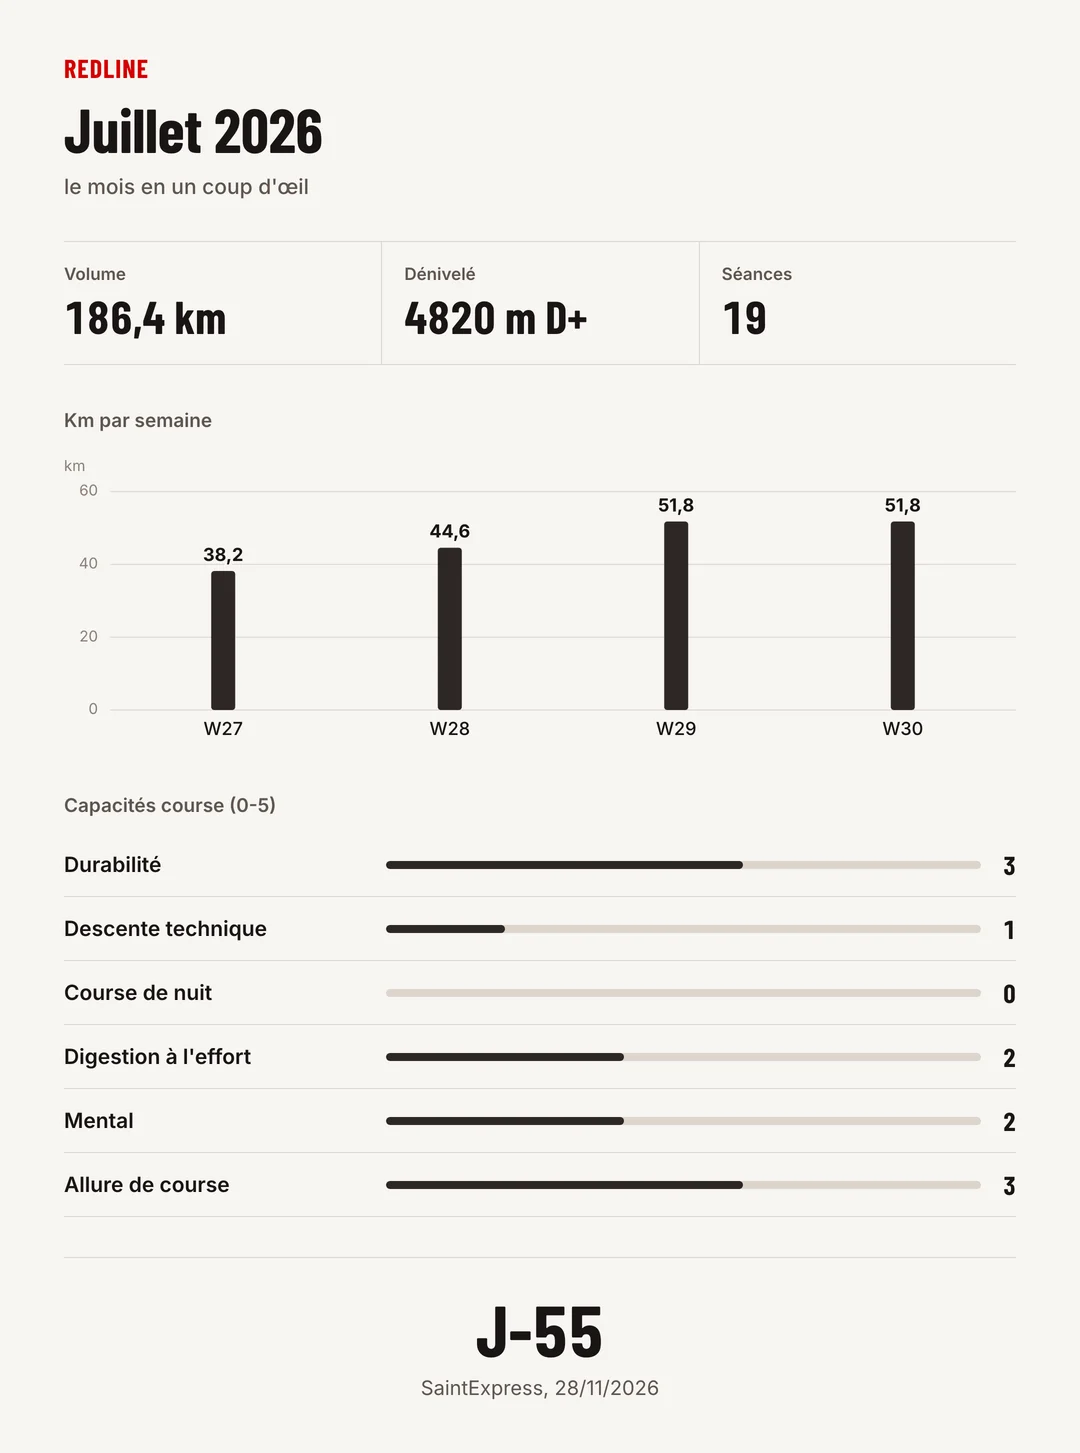
Je ne voulais pas d’un tableau de bord de plus à penser à ouvrir. Le coach écrit en premier : un mot le matin, un débrief dès que Strava a synchronisé la sortie, un bilan chaque dimanche, et je réponds en quelques mots. Ça reste un outil d’entraînement : il tient le carnet et le plan, et ne remplace ni un coach, ni un médecin, ni les gens qui m’entourent.
Débrief après une séance de qualité
Le matin d’une séance de renfo
Bilan du mois
Cartes rendues par Redline à partir de données synthétiques.
Le modèle propose, le code décide
Le modèle rédige la réponse et propose des changements : une séance consignée, une semaine révisée. Le code applique ces changements en une seule transaction, ou aucun, puis refuse de prescrire depuis un plan invalide ou périmé. Le programme que je reçois est rendu depuis la base, jamais recopié de la prose du modèle.
01 · EntréeUn message ou une sortieDepuis Messenger ou Strava. Enregistré avant tout le reste : un crash ne perd rien.
02 · ModèleTriUn petit modèle choisit l’un des quatre niveaux.
03 · ModèleLe coachLit ce que son niveau autorise, rédige la réponse et propose des changements typés.
04 · CodeTout ou rienLes changements s’appliquent en une transaction, ou aucun.
05 · CodeContrôlesSans plan valide et à jour, aucune prescription. La réponse part quand même.
06 · CodeLivraisonLe programme est rendu depuis la base, et chaque envoi est journalisé.
Le bon modèle pour chaque message
Un merci ne demande pas le même modèle qu’une question sur une douleur. Chaque message est classé dans l’un de quatre niveaux, qui fixe ce que le coach lit et quel modèle répond. Claude et Codex sont derrière la même interface : changer de fournisseur tient en un réglage.
Niveau
Un jugement
Modèle
Sonnet, plus d’effort
Ce que le coach lit
Un résumé d’une page de l’état actuel
Le plan de la semaine et les faits du jour
Les règles et notes derrière la décision
Les sources elles-mêmes, et le web si elles ne tranchent pas
Le tri lui-même tourne sur le plus petit modèle. S’il échoue ou dépasse 10 secondes, le message est traité comme une routine.
Messages d’exemple. Le routage affiché est la configuration Claude utilisée aujourd’hui.
Les faits ne sont pas le raisonnement
Ce qui s’est passé et ce qui est prévu vit dans PostgreSQL : typé, contraint, jamais écrasé. Le pourquoi vit dans des notes versionnées que je peux relire et contester. Chaque fait a un seul propriétaire, et ce qui peut se recalculer ne se stocke pas : deux versions de la vérité ne peuvent pas diverger.
PostgreSQLFaits
Ce qui s’est passé, et ce qui est prévu. Typés, contraints, immuables une fois connus.
Séances, effort et douleur notés
Plans de la semaine, en révisions qui n’écrasent jamais
Échéances et questions ouvertes
Notes versionnées · GitRaisonnement
Pourquoi cela a été décidé. Lisible, versionné, contesté chaque mois.
Objectifs et règles de coaching
Décisions, chacune avec une prédiction datée
37 concepts construits à partir de 113 sources
La forme, les tendances et la charge de la semaine se recalculent depuis les deux, sans jamais être stockées.
Une bibliothèque qu’il a vraiment lue
Le savoir du coach vient de 73 transcriptions de podcasts et d’une recherche systématique dans la littérature médicale, transformées en 113 notes de source et 37 concepts. Une affirmation garde son niveau de preuve partout où elle est citée, et un contrôle automatique signale les affirmations connues qui le perdent en route.
Mesurer, corriger, rejouer
Quand je corrige le coach, l’erreur est consignée avec ce qu’il aurait dû lire, et le correctif reçoit un porteur. Un banc d’évaluation rejoue 40 scénarios sur les vrais modèles, avec un modèle dans le rôle du juge, tenu hors de la conversation réelle. Les décisions portent une prédiction datée : une erreur de jugement apparaît au lieu de s’effacer.
Correction · 2 août 2026
« 2224,5 km propres, bien joué. »
22, c’était le volume prévu : une intention citée comme un fait. Le registre des séances disait déjà 24,5 km.
Ce qui porte désormais la correction
Règle
Un chiffre se calcule, il ne se cite pas. Prévu et fait sont étiquetés quand ils sont nommés ensemble.
Code
Un seul calcul du volume de la semaine, partagé par tous les outils.
Test
Un scénario du banc pose la même question à chaque passage.
scénarioweekly-volume-is-computed
questionC’est quoi le kilométrage de la semaine dernière ?
registre30,18 km en 4 sorties · cible du plan ~28 km
attendu30,2 km sur 4 sorties.
critèreLe chiffre donné est 30,2 km, pas 28
critèreAucun souvenir, calcul ou outil inventé
Jugé à chaque passage du banc, sur les vrais modèles
Tous les visuels Redline utilisent des données synthétiques.